跨境电商
一人公司怎么做 AI 自动化?从业务审计到电商工作流搭建
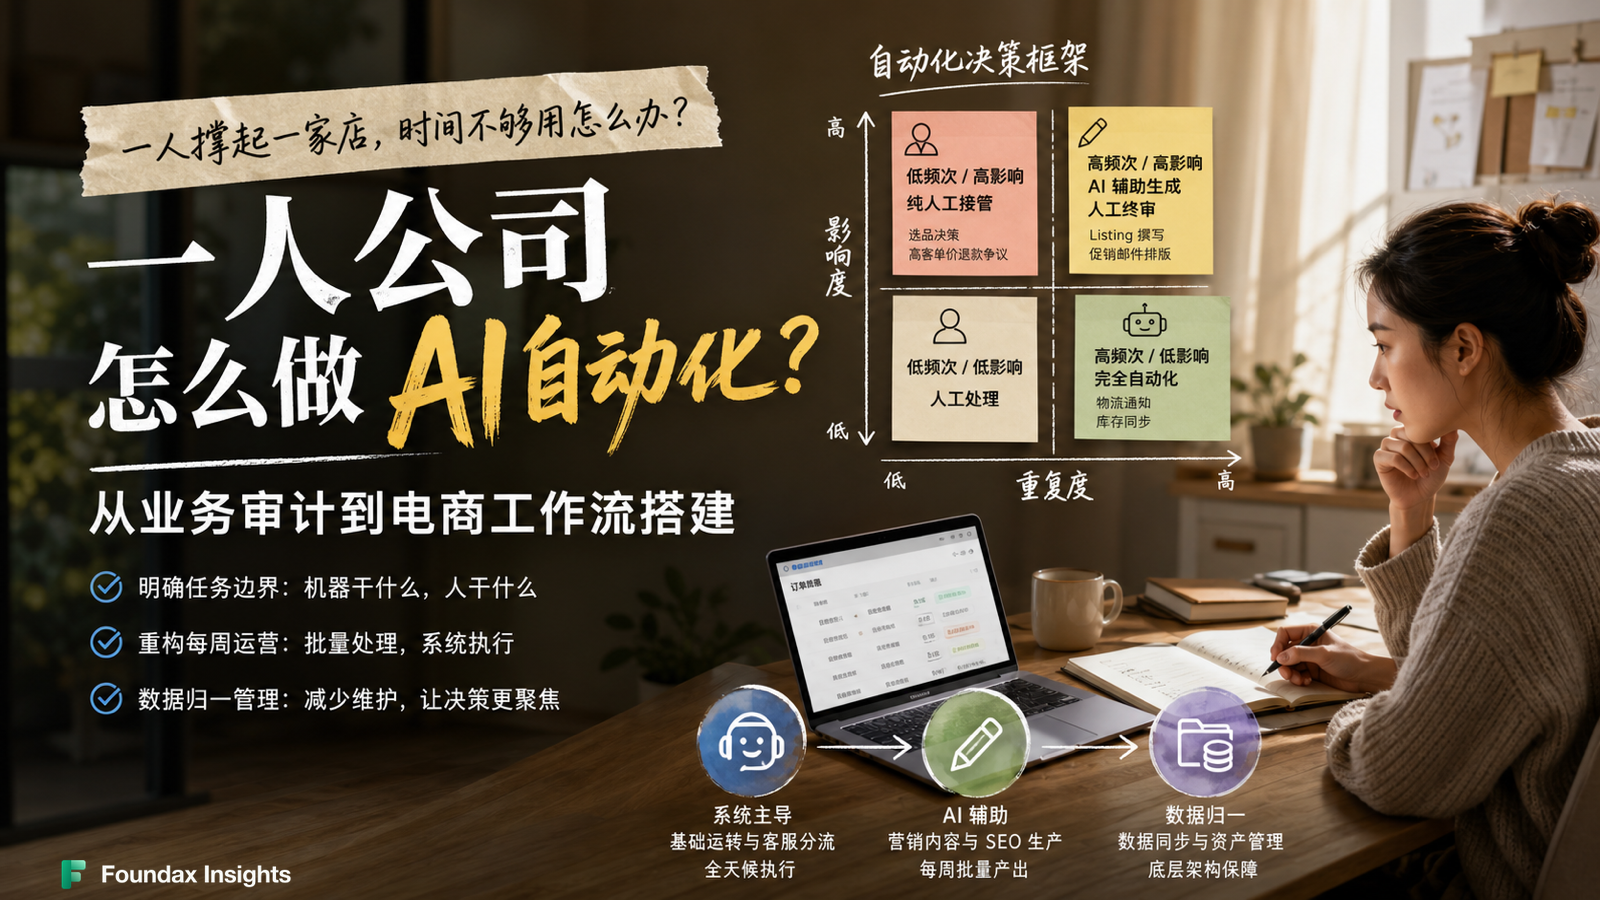
当团队只有你一个人时,乱上工具反而会拖累效率。这是一份面向单人电商的工作流治理框架,带你盘点日常业务,弄清哪些环节该交给人、规则还是 AI,从而建立真正能运转的自动化体系。
阅读全文
刚开始做 AI 自动化,千万别什么都想交给机器。通过拆解耗时、频率、错误代价和数据敏感度,我们将带你对日常任务进行审计,选出第一条最稳妥的自动化工作流,并建立明确的效率评估基线。
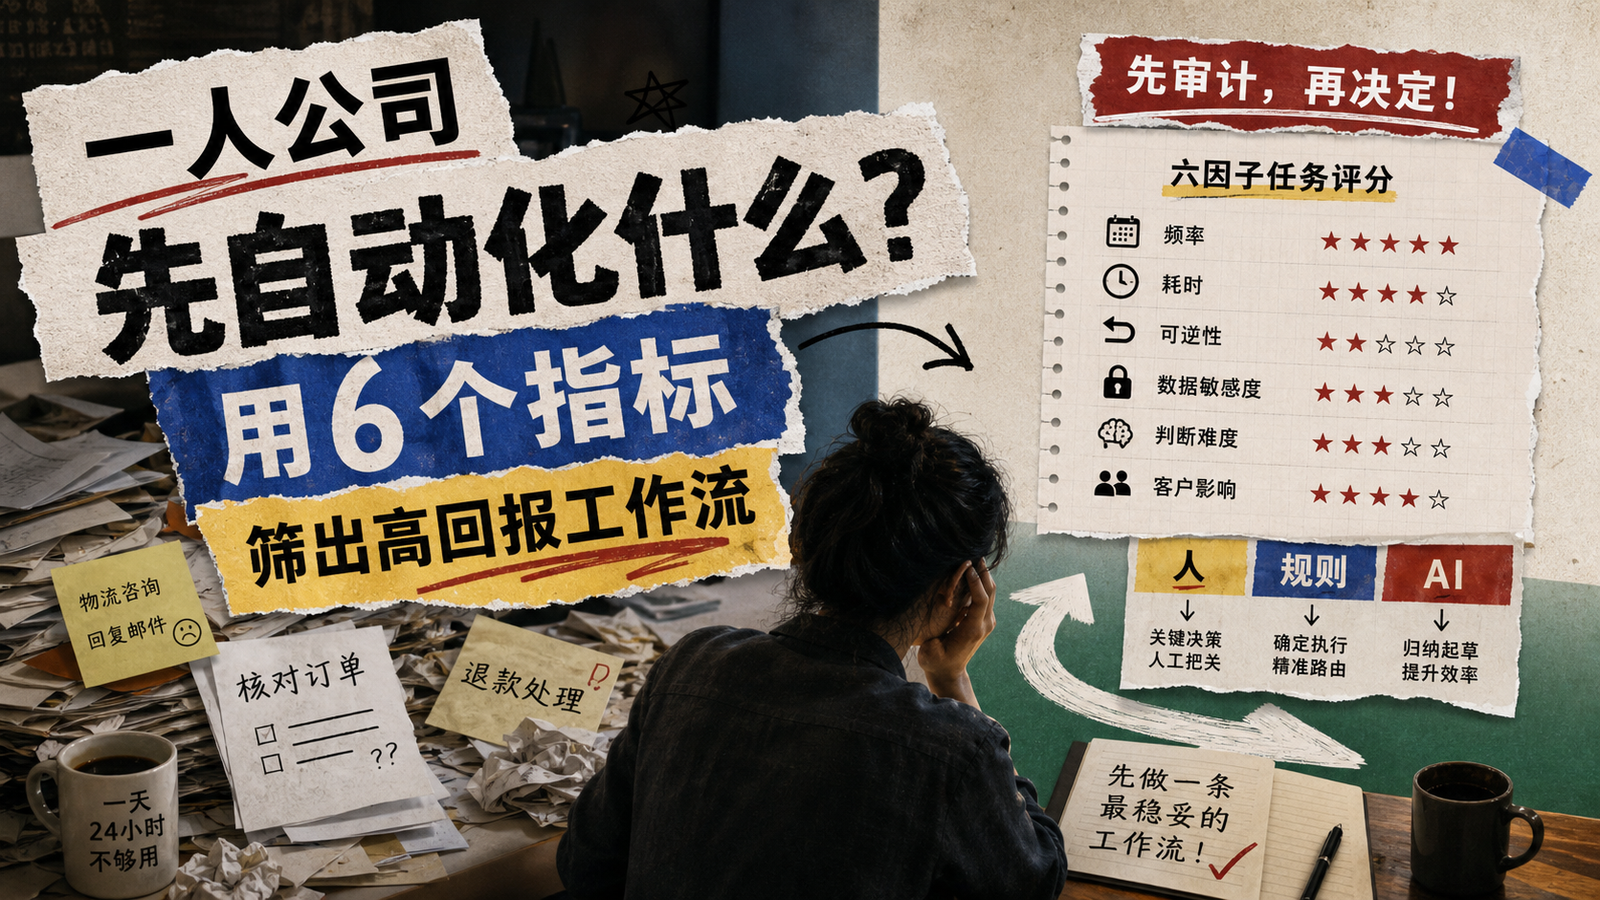
一人公司的日常往往在多重角色间极限拉扯:刚刚还在回复客户关于物流的追问,转头又要核对错综复杂的订单表格。尝试引入 AI 和自动化来缓解运营压力,却常在起步阶段陷入两难——从哪一项任务开始最见效?如果机器判断失误导致退款错误或客户流失,这个风险谁来承担?
IBM 在 AI in Customer Service 与 What is Contact Center Automation? 中指出了明确的方向:AI 与自动化适合加速、个性化并分流支持,但复杂或高影响互动仍需要人工角色;真人与虚拟坐席需要互补协作,平稳的工作流自动化离不开两者的明确分工。
基于这一逻辑,我们必须通过冷酷的任务审计,将日常运营拆解,把任务精准分配给人、规则或 AI。
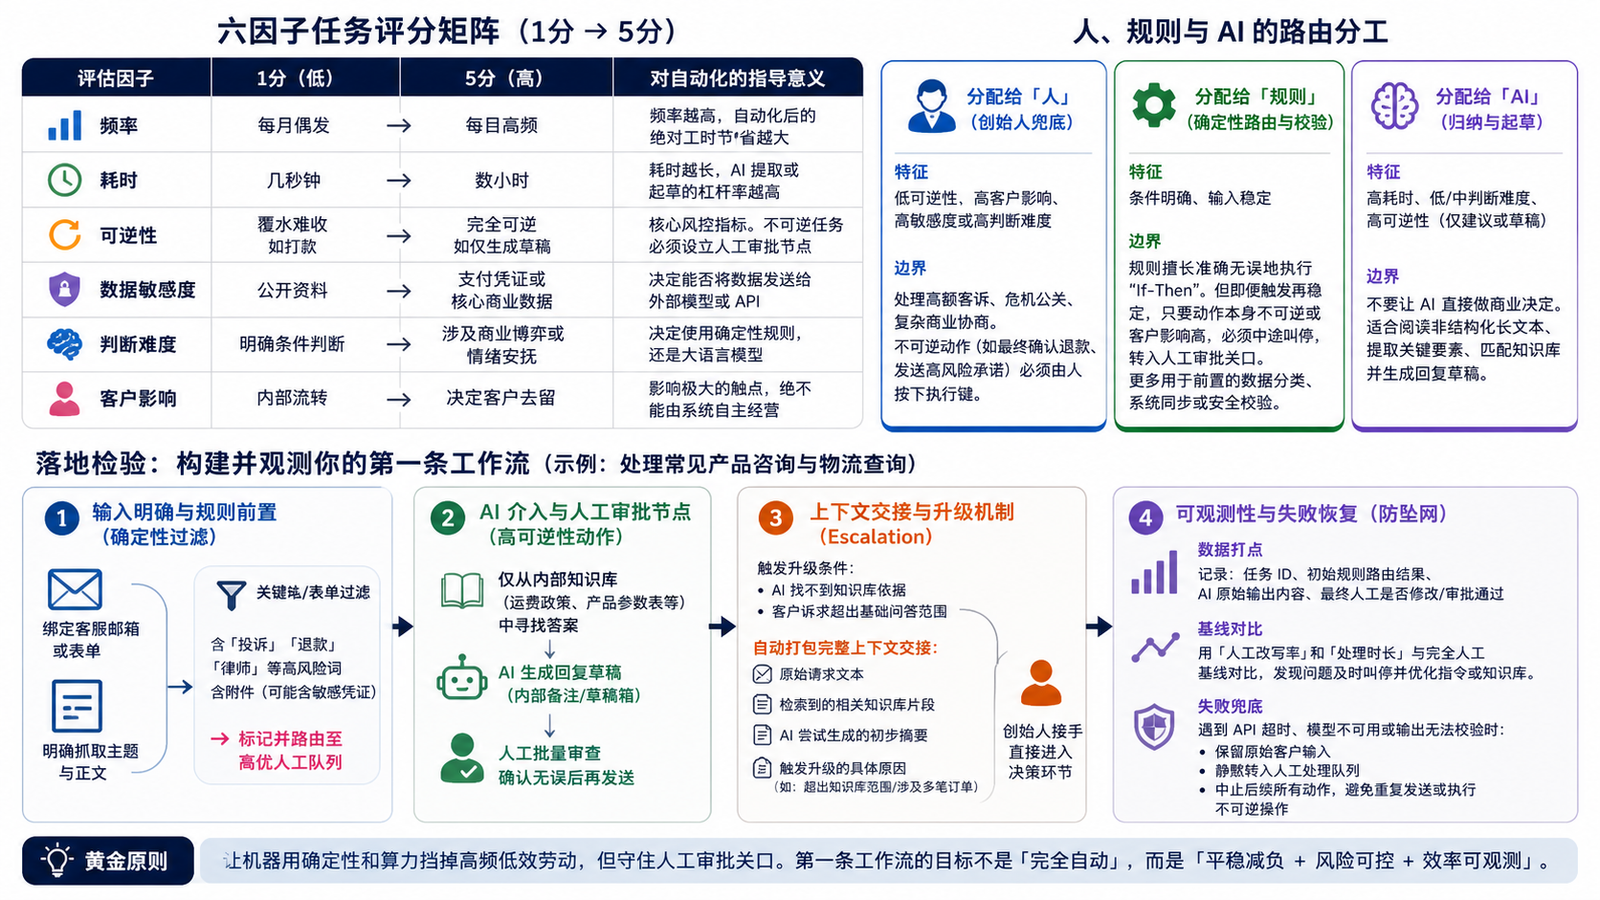
在配置任何自动化工具前,请先用以下六个维度对你的日常任务进行 1-5 分的评估。这是决定任务流向的硬性标准。
| 评估因子 | 核心定义与评估标准 (1分 -> 5分) | 对自动化的指导意义 |
|---|---|---|
| 频率 | 发生频次(1 = 每月偶发;5 = 每日高频) | 频率直接决定了自动化后的绝对工时节省量。 |
| 耗时 | 单次处理时长(1 = 几秒钟;5 = 数小时) | 耗时越长,引入 AI 提取或起草信息的杠杆率越高。 |
| 可逆性 | 错误发生后的挽回成本(1 = 覆水难收,如打款;5 = 完全可逆,如仅生成后台草稿) | 核心风控指标。不可逆任务必须设立人工审批节点。 |
| 数据敏感度 | 涉及信息的私密程度(1 = 公开资料;5 = 支付凭证或核心商业数据) | 敏感度决定了能否将数据发送给外部模型或 API。 |
| 判断难度 | 决策依赖的上下文(1 = 明确条件判断;5 = 涉及商业博弈或情绪安抚) | 决定了是使用确定性的条件规则,还是大语言模型。 |
| 客户影响 | 结果对客户体验的作用(1 = 内部流转;5 = 决定客户去留) | 影响极大的触点绝不能由系统自主经营。 |
基于六因子评分,我们可以清晰地界定边界,避免“把高风险判断交出去”的误区:
假设你经过审计,选中了“处理常见产品咨询与物流查询”作为第一条工作流(高频、中耗时、要求高可逆性)。一个能够真正落地并可检查的工作流,绝不仅仅是“接入数据 - AI 生成 - 人工发送”这么简单,它必须包含清晰的规则前置、严谨的交接机制与失败恢复能力。
工作流的第一步必须是确定性的规则。
对于通过规则校验的常规咨询,才调用 AI 处理需要归纳或起草的部分。
当 AI 找不到内部知识库依据,或者判定客户诉求超出基础问答范围时,必须立刻触发升级条件,交由创始人处理。
工作流上线不是终点,必须对其运行状态进行观测。
自动化的核心价值,在于利用机器的确定性和算力为你挡掉高频的低效劳动,而不是用未知的黑盒替代你的商业直觉。守住人工审批的关口,你的第一条自动化工作流才能真正实现平稳减负。
不是。插件在解决专业问题时很有用。风险出现在核心商品、SEO、内容、政策、feed 或 analytics 职责被拆到多个没有共同 owner 的工具里。
没有通用阈值。更好的判断是:每个 app 是否有明确任务、数据边界、负责人、页面范围、性能成本和复核日期。
商品数据、页面发布、SEO metadata、Product JSON-LD、sitemap、robots、本地化、feed 预检、内容发布和第一方交易 analytics,应该尽量靠近核心系统。
当某个 app 做的是核心系统不应该负责的专业工作,例如 email marketing、仓储集成、高级 review、loyalty、helpdesk routing 或 marketplace-specific operations,就可以保留。
Foundax 把商品记录、storefront 发布、Content Studio、多语言内容、SEO 配置、Product JSON-LD、Search Console、Merchant Center 预检、第一方 analytics 和 GA4 诊断连接在同一条运营路径里,减少核心运营被 app 拼接的情况。