跨境电商
一人公司怎么做 AI 自动化?从业务审计到电商工作流搭建
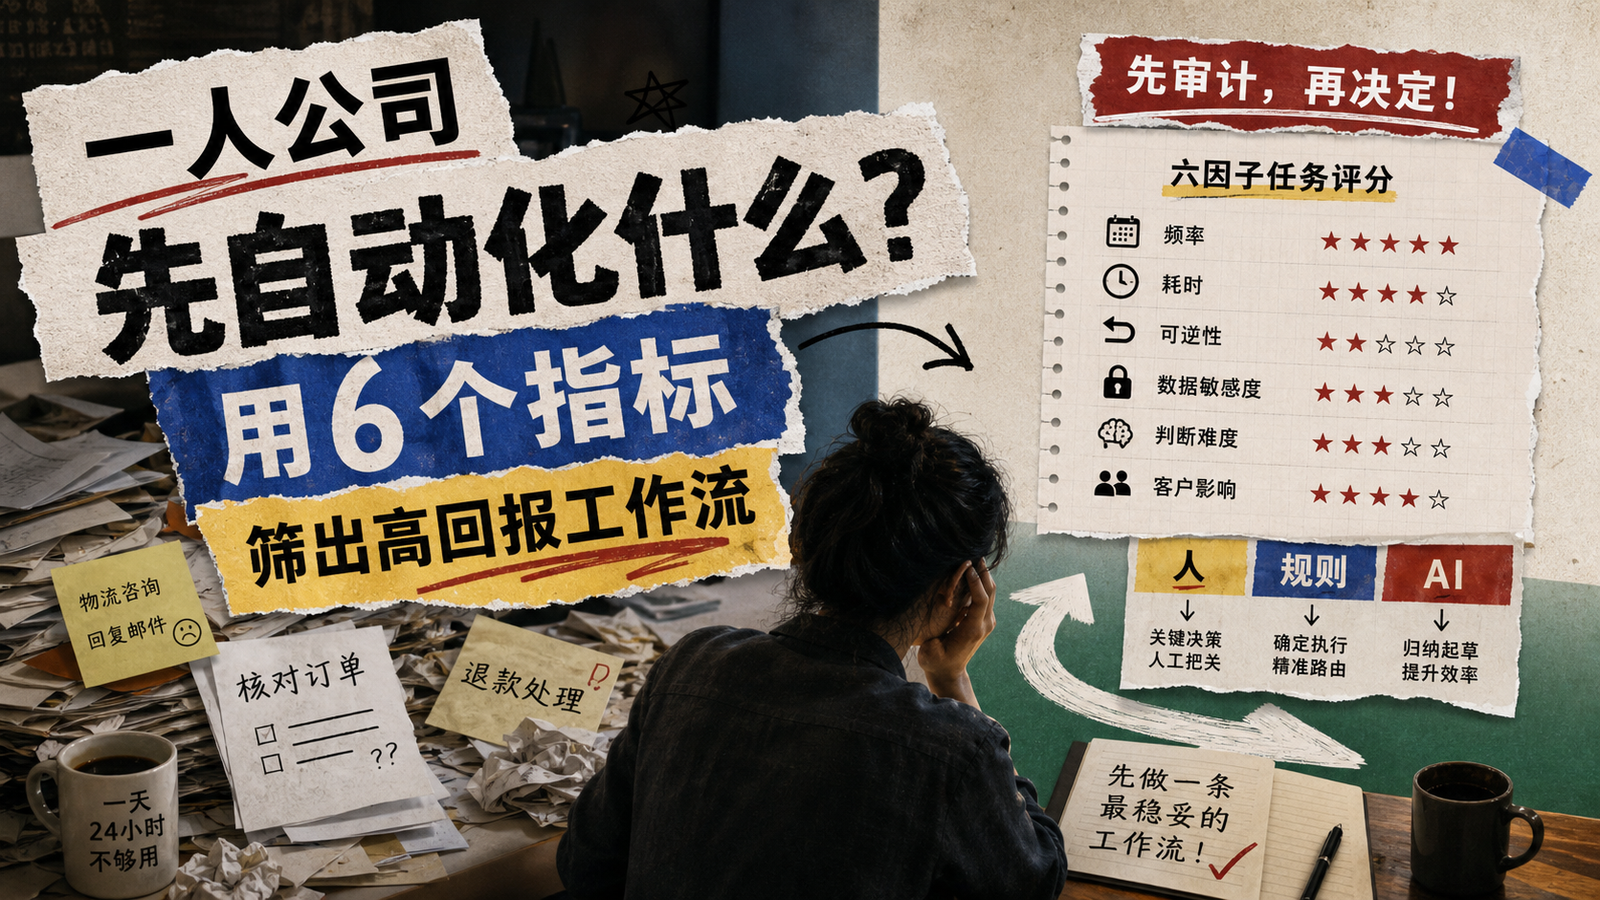
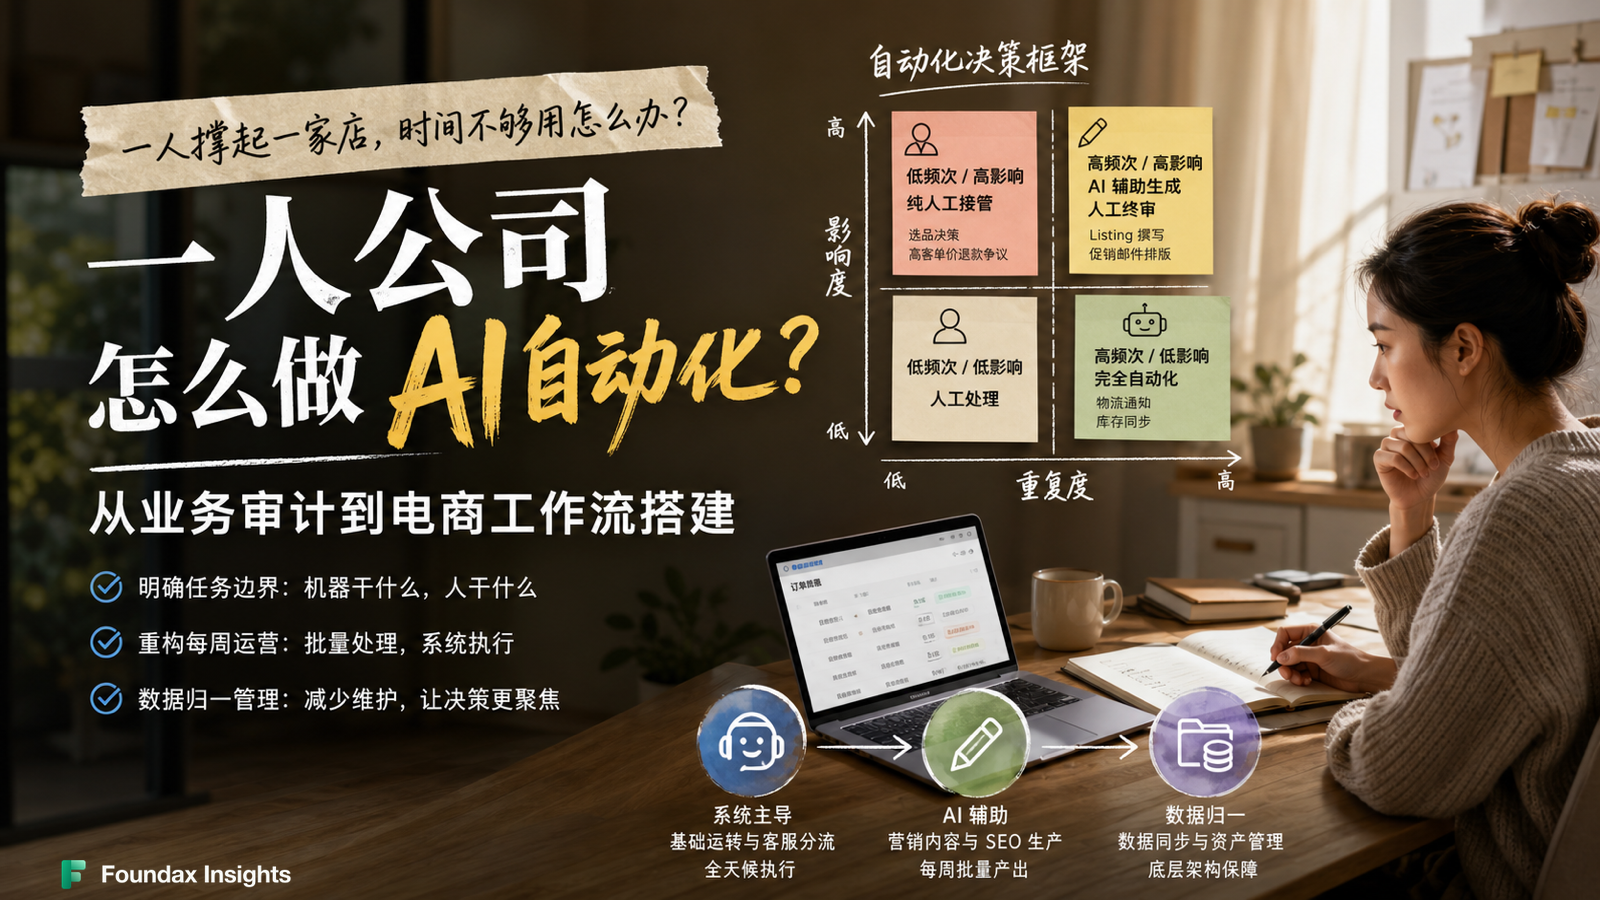
当团队只有你一个人时,乱上工具反而会拖累效率。这是一份面向单人电商的工作流治理框架,带你盘点日常业务,弄清哪些环节该交给人、规则还是 AI,从而建立真正能运转的自动化体系。
阅读全文
一个小型跨境电商团队,到底要先统一哪些业务数据,才能让自动化和 AI 真正可用,而不是把错误放大?本文提供从商品源头到运营终端的数据栈分阶段落地规划。
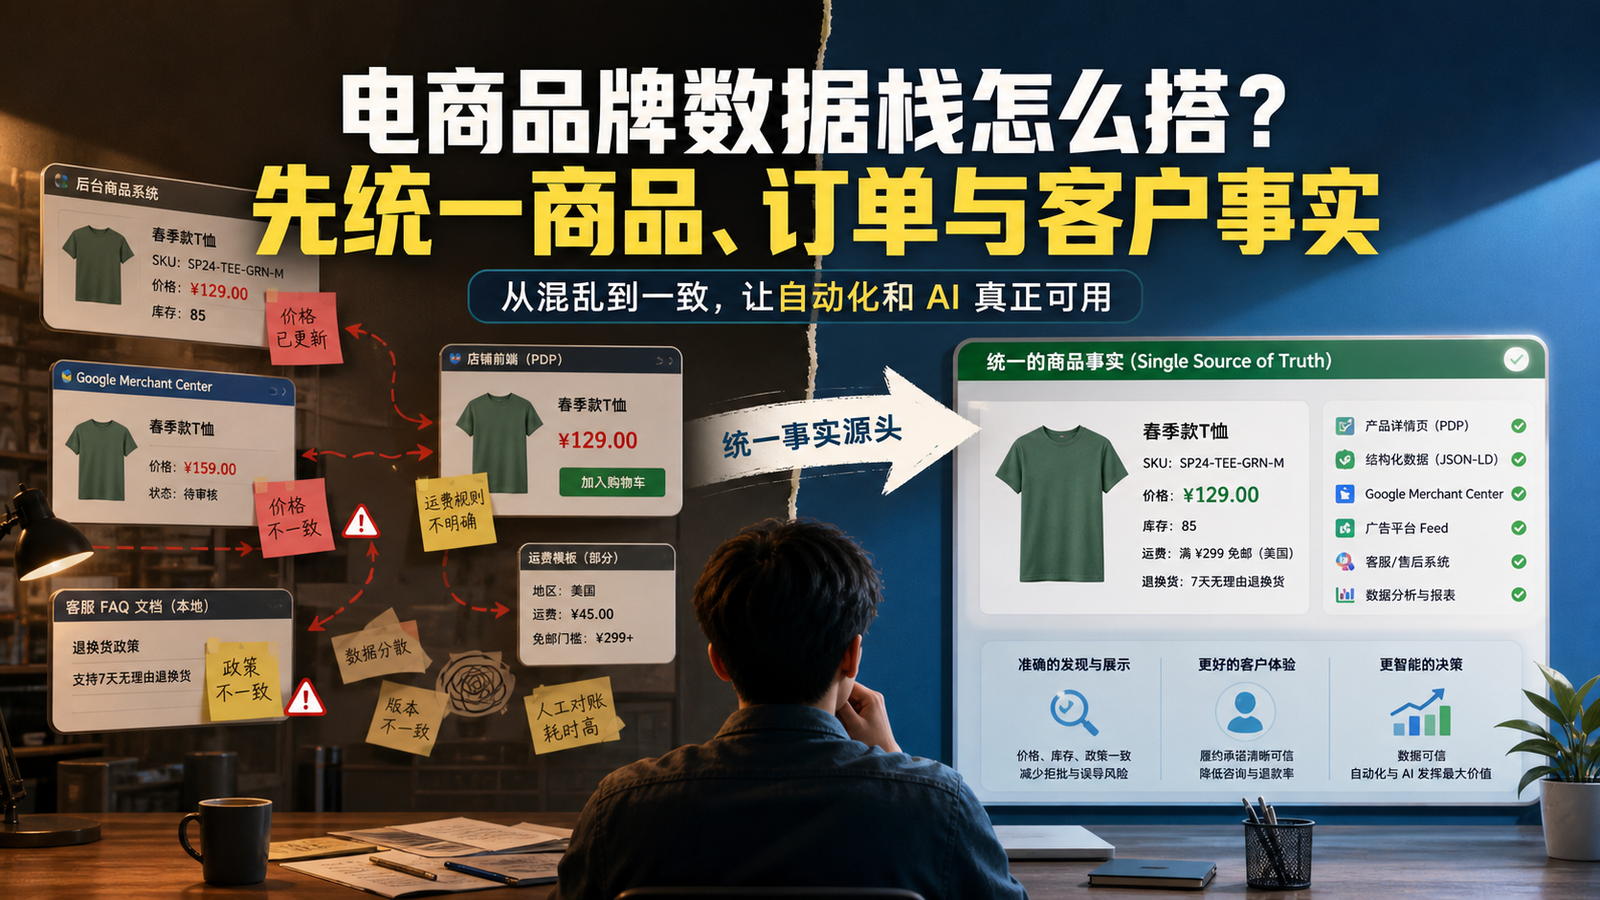
想象一个典型的五人跨境电商团队:商品经理在系统后台更新了春季款的变体价格,运营在店铺首页替换了活动海报,代理商在 Google Merchant Center (GMC) 设置了用于补充参数的 Feed 规则,而客服团队则在本地维护着一份包含退换货条款的 FAQ 文档。
这种分散的运作模式在团队规模较小时非常普遍。但当品牌试图引入更多自动化流程,或迎合外部 AI 购物发现系统时,数据分散带来的就不只是内部沟通成本了。当各个系统各自维护一份业务事实的副本时,数据冲突的风险就会传导给前端系统,让自动化工具把错误的信号放大。
在构建数据栈之前,团队必须识别出系统中的“数据漂移”现象。以下是一些常见的假设场景,展示了数据不一致可能引发的具体运营风险:
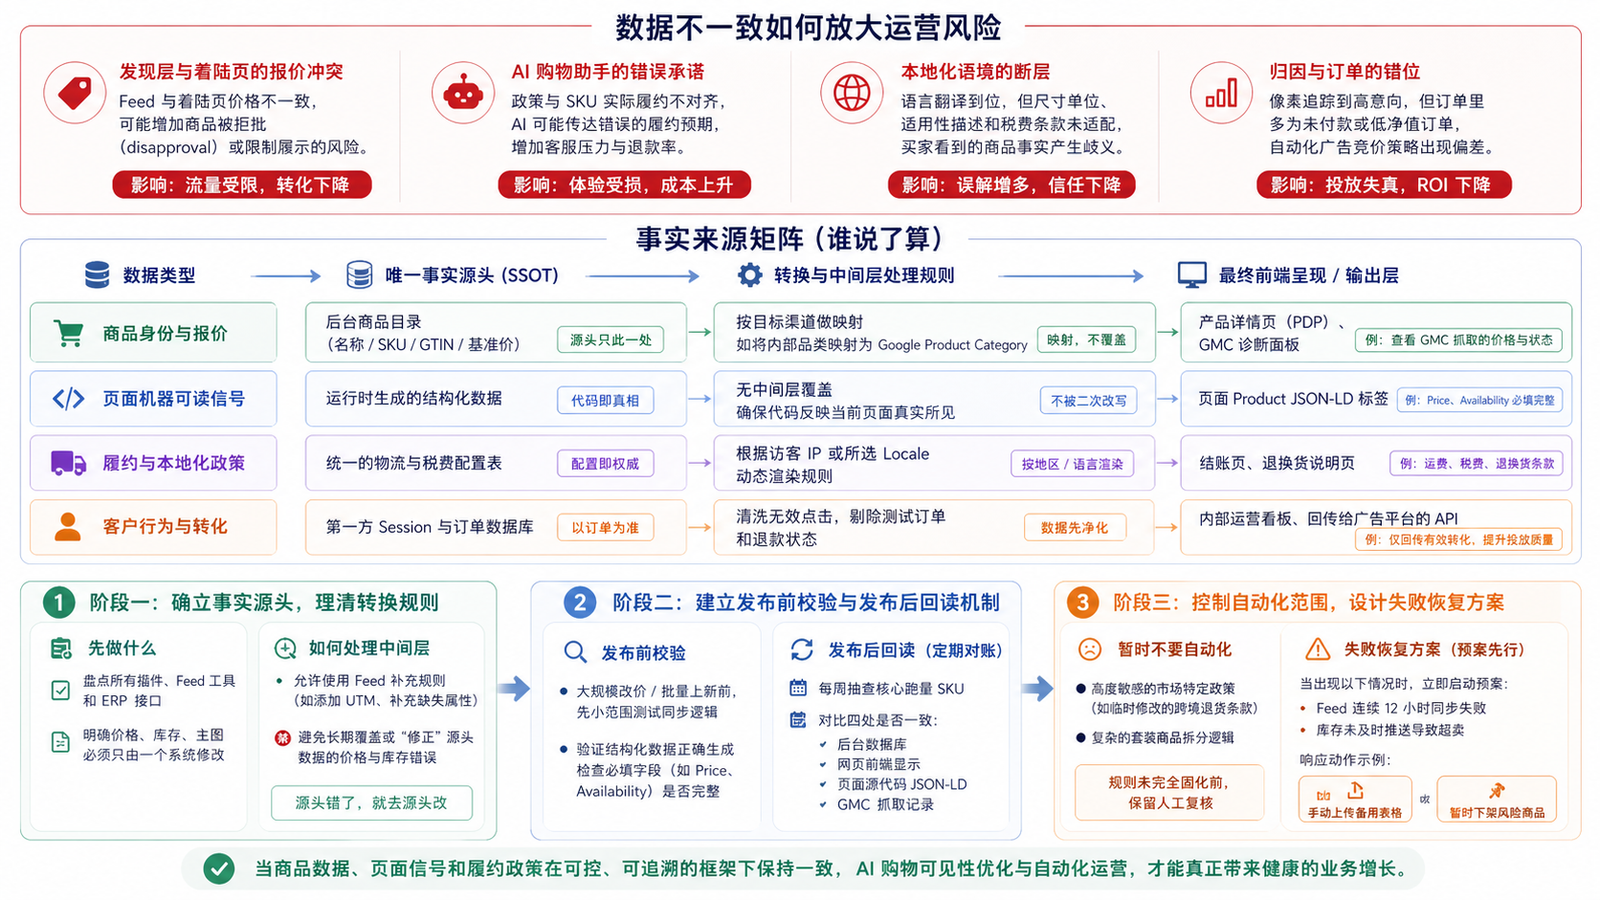
要降低上述风险,核心不是要求所有数据必须在毫秒级内自动同步到所有表面,而是要建立清晰的“唯一事实来源(Single Source of Truth)”契约。你需要明确哪一层是源头,哪一层是转换规则,哪一层是最终输出。
| 数据类型 | 唯一事实源头 (SSOT) | 转换与中间层处理规则 | 最终前端呈现/输出层 |
|---|---|---|---|
| 商品身份与报价 | 后台商品目录 (名称/SKU/GTIN/基准价) | 按目标渠道做映射(如将内部品类映射为 Google Product Category) | 产品详情页 (PDP)、GMC 诊断面板 |
| 页面机器可读信号 | 运行时生成的结构化数据 | 无中间层覆盖,确保代码反映当前页面真实所见 | 页面 Product JSON-LD 标签 |
| 履约与本地化政策 | 统一的物流与税费配置表 | 根据访客 IP 或所选 Locale 动态渲染规则 | 结账页、退换货说明页 |
| 客户行为与转化 | 第一方 Session 与订单数据库 | 清洗无效点击,剔除测试订单和退款状态 | 内部运营看板、回传给广告平台的 API |
对于资源有限的小型团队,不要试图一步到位实现全链路的自动化。建议通过以下三个阶段逐步建立可维护的数据治理工作流:
不要一概否定 GMC 内部规则或人工上传的价值。在早期,中间层修正往往是必要的,但必须规范其使用方式。
不强求每次商品变更都实现全网瞬间同步,但必须建立验证机制,确保系统最终能达成一致。
当数据的准确性得到初步验证后,再谨慎引入自动化同步,并时刻准备好应对同步失败。
只有当商品数据、页面信号和履约政策能在一个可控、可追溯的框架下保持一致时,你投入的 AI 购物可见性优化和自动化运营策略,才能真正带来健康的业务增长。
电商数据栈是让商品数据、店铺页面、merchant feed、内容、本地化、analytics 和渠道集成保持一致的运营结构。它可以包含多个工具,但每个重要事实都需要清楚的来源。
最重要的是商品识别码、标题、描述、变体、图片、价格、库存、配送与退货语境、页面 metadata、structured data、客户事件和订单记录。它们同时影响买家体验和外部发现系统。
技术栈列出公司使用哪些工具;数据栈说明事实如何在工具之间流动。当商品事实、公开页面、merchant feed 和 analytics 使用同一套定义时,数据栈才健康。
是。AI shopping 让结构化且一致的商品信息更重要,因为助手和搜索体验会依靠 metadata、merchant feed、公开页面内容和评论来理解商品。
当人工对账变成日常工作时就应该升级:频繁修 feed、本地化页面不一致、analytics 定义不清、商品记录重复,或一次商品变更需要多人更新多个系统。